Mengenal Mekanisme Data Deduplication pada Sistem Informasi Slot
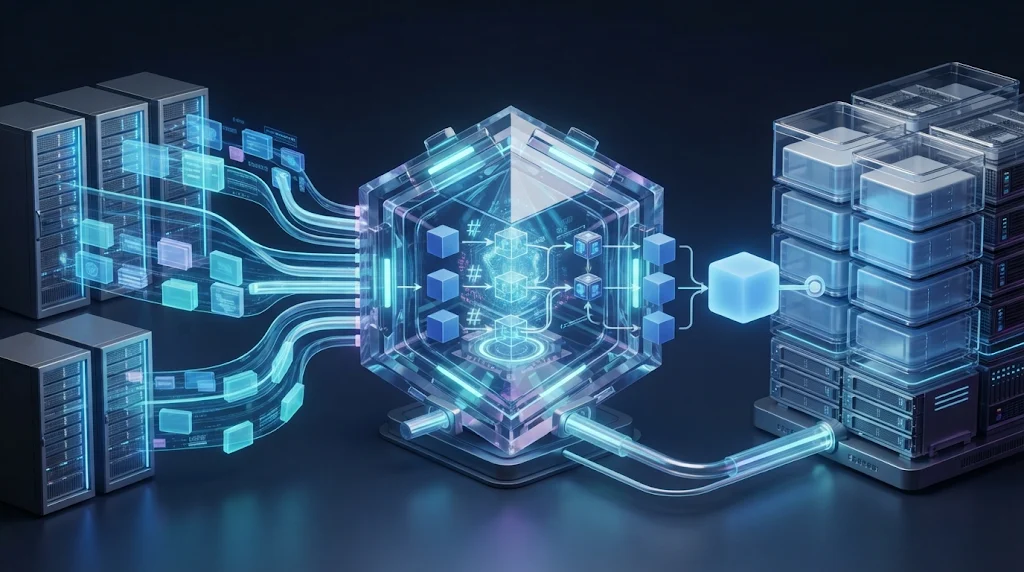
Pengelolaan informasi pada platform slot digital membutuhkan sistem penyimpanan yang terstruktur dan efisien. Setiap aktivitas aplikasi dapat menghasilkan catatan data dalam jumlah besar. Namun, proses pengumpulan informasi dari berbagai sumber terkadang menghasilkan catatan yang sama lebih dari satu kali. Kondisi tersebut dapat meningkatkan penggunaan penyimpanan dan memengaruhi kualitas analisis.
Untuk mengatasi masalah tersebut, pengembang dapat menerapkan mekanisme data deduplication. Teknologi ini bertujuan mengidentifikasi dan mengurangi penyimpanan data yang berulang. Melalui proses tersebut, sistem dapat menjaga efisiensi penyimpanan sekaligus meningkatkan konsistensi informasi. Oleh karena itu, data deduplication menjadi salah satu pendekatan penting dalam pengelolaan sistem informasi modern. Berikut ini akan membahas tentang Mengenal Mekanisme Data Deduplication pada Sistem Informasi Slot.
Mengenal Konsep Data Deduplication
Data deduplication merupakan proses mendeteksi dan menghilangkan salinan data yang identik atau berulang. Mekanisme ini membantu sistem menyimpan informasi secara lebih efisien tanpa mempertahankan banyak salinan yang tidak diperlukan.
Dalam platform slot digital, duplikasi dapat muncul dari berbagai sumber. Contohnya adalah log aplikasi yang terkirim berulang, hasil sinkronisasi database, atau file cadangan yang memiliki isi sama.
Meskipun demikian, tidak semua catatan yang terlihat serupa merupakan duplikasi. Dua aktivitas dapat memiliki isi hampir sama, tetapi berasal dari waktu atau proses yang berbeda. Karena itu, sistem membutuhkan aturan identifikasi yang tepat sebelum menghapus atau menggabungkan informasi.
Bagaimana Mekanisme Data Deduplication Bekerja?
Proses deduplikasi melibatkan beberapa tahapan untuk memastikan sistem dapat mengenali informasi yang berulang. Setiap tahap memiliki fungsi dalam menjaga ketepatan hasil.
1. Data Identification
Tahap pertama adalah mengidentifikasi data yang akan diperiksa. Sistem menentukan atribut atau bagian informasi yang digunakan sebagai dasar perbandingan.
Sebagai contoh, sistem dapat memeriksa file log berdasarkan isi, ukuran, dan identitas sumber. Untuk catatan database, pengembang dapat menggunakan kombinasi atribut tertentu sebagai penanda keunikan.
Pemilihan atribut harus mempertimbangkan karakteristik data. Jika aturan identifikasi terlalu sederhana, sistem berisiko menganggap dua informasi berbeda sebagai data yang sama.
2. Hashing dan Fingerprinting
Salah satu metode yang sering digunakan adalah hashing. Metode ini menghasilkan nilai hash berdasarkan isi data melalui algoritma tertentu.
Sistem kemudian membandingkan nilai hash untuk menemukan kemungkinan duplikasi. Jika dua data menghasilkan nilai yang sama, sistem dapat melanjutkan pemeriksaan untuk memastikan kesesuaiannya.
Namun, hash tidak selalu menjadi bukti mutlak bahwa dua data identik karena kemungkinan tabrakan nilai hash tetap ada. Oleh sebab itu, sistem yang membutuhkan ketepatan tinggi dapat melakukan pemeriksaan tambahan terhadap isi data.
3. Duplicate Detection
Setelah proses identifikasi, sistem menentukan apakah informasi termasuk duplikasi. Pemeriksaan dapat dilakukan berdasarkan nilai hash, kunci unik, atau kombinasi beberapa atribut.
Misalnya, sistem menerima catatan log yang sama sebanyak dua kali akibat pengiriman ulang. Mekanisme deduplikasi dapat mengenali catatan tersebut berdasarkan identitas peristiwa dan informasi pendukung.
Dengan demikian, sistem dapat mencegah penyimpanan berulang yang tidak diperlukan.
4. Data Consolidation
Tahap berikutnya adalah mengelola catatan yang telah teridentifikasi sebagai duplikasi. Sistem dapat mempertahankan satu salinan utama dan menghubungkan referensi dari salinan lainnya.
Dalam penyimpanan berbasis file, pendekatan ini dapat menggunakan referensi ke blok data yang sama. Sementara itu, pada database, sistem dapat menerapkan aturan unik atau proses penggabungan catatan.
Jenis Data Deduplication dalam Sistem Informasi
Data deduplication memiliki beberapa pendekatan berdasarkan bagian informasi yang diperiksa.
File-Level Deduplication
Metode ini membandingkan file secara keseluruhan. Jika dua file memiliki isi identik, sistem dapat menghindari penyimpanan salinan tambahan.
Pendekatan ini cocok untuk mengelola arsip, file log, dan cadangan sistem. Namun, perubahan kecil pada satu bagian file dapat membuat sistem menganggapnya sebagai file berbeda.
Block-Level Deduplication
Block-level deduplication membagi file menjadi beberapa blok kecil sebelum membandingkannya. Sistem hanya menyimpan blok baru yang belum tersedia.
Metode ini dapat meningkatkan efisiensi ketika sebagian besar isi file tetap sama. Teknologi tersebut sering digunakan pada sistem backup dan penyimpanan berskala besar.
Record-Level Deduplication
Metode ini memeriksa setiap catatan dalam database. Sistem menggunakan kunci unik atau kombinasi atribut untuk menemukan informasi yang berulang.
Sebagai contoh, catatan peristiwa dengan identitas unik yang sama dapat diperiksa sebelum dimasukkan ke tabel. Pendekatan ini membantu menjaga konsistensi data operasional.
Manfaat Data Deduplication bagi Platform Slot Digital
Penerapan deduplikasi memberikan beberapa manfaat bagi pengelolaan informasi. Pertama, mekanisme ini dapat mengurangi kebutuhan kapasitas penyimpanan. Sistem tidak perlu mempertahankan banyak salinan identik yang sebenarnya tidak diperlukan.
Kedua, deduplikasi membantu meningkatkan kualitas analisis. Catatan berulang dapat menyebabkan perhitungan menjadi tidak akurat, terutama ketika sistem menghitung jumlah aktivitas atau kejadian tertentu. Dengan mengendalikan duplikasi, laporan operasional menjadi lebih konsisten.
Ketiga, mekanisme ini mendukung efisiensi pengelolaan backup. Pengurangan data berulang dapat mempercepat proses penyimpanan dan pemindahan cadangan, bergantung pada arsitektur yang digunakan.
Tantangan dalam Penerapan Data Deduplication
Meskipun bermanfaat, deduplikasi membutuhkan aturan identifikasi yang akurat. Sistem yang salah mengenali data dapat menghapus informasi berbeda yang sebenarnya penting.
Selain itu, proses hashing dan perbandingan membutuhkan sumber daya komputasi. Pengembang perlu menyesuaikan metode deduplikasi dengan ukuran serta karakteristik data.
Keamanan juga harus diperhatikan, terutama ketika sistem menggunakan penyimpanan bersama. Pengaturan akses, validasi integritas, dan mekanisme pemulihan perlu diterapkan agar informasi tetap terlindungi.
Kesimpulan
Data deduplication merupakan mekanisme penting untuk mengurangi penyimpanan informasi berulang pada sistem platform slot digital. Prosesnya mencakup identifikasi, hashing, pemeriksaan duplikasi, dan pengelolaan salinan data.
Dengan penerapan aturan yang tepat, sistem dapat menghemat kapasitas penyimpanan dan menjaga konsistensi analisis. Namun, pengembang tetap perlu memperhatikan ketepatan identifikasi, kebutuhan komputasi, dan keamanan informasi. Pendekatan tersebut membantu menciptakan pengelolaan data yang lebih efisien dan terukur.
Related Post

Slot bertema tambang emas yang seru
Slot bertema tambang emas yang seru selalu berhasil memikat pemain slot online. Dengan latar suasana [...]
Slot dengan fitur hewan peliharaan pendamping
Slot online telah berevolusi menjadi lebih dari sekadar permainan gulungan berputar. Kini, banyak pengembang menambahkan [...]